不上 RAG,是这个汽修项目里最对的一个决定
这条在讲 Alex Georgiev 发在 DEV Community 的 BMW Repair Workshop——朋友自己修一台 E90 325i,他搭个 AI 查修车信息。我点开的时候没抱期待,又一个拿 LLM 给垂直领域套壳的东西。一般节奏是:喂官方手册、上 RAG、做漂亮架构图。
这条在讲 Alex Georgiev 发在 DEV Community 的 BMW Repair Workshop——朋友自己修一台 E90 325i,他搭个 AI 查修车信息。我点开的时候没抱期待,又一个拿 LLM 给垂直领域套壳的东西。一般节奏是:喂官方手册、上 RAG、做漂亮架构图。
这篇《Returning to Development States: When Full Sandbox Snapshots Help Coding Agents》把编码 agent 的失败恢复重新当搜索问题摆了一遍。结论先给:主流的从头重试是在浪费计算,diff 重建只补一半,而且基本上不是最关键的那半;
那个晚上我扫了一眼标题,没点开摘要。KV cache 复用、跨模型迁移、选择性重算——这几个词放一起太像那种“我们在某某设定下优化了某某指标”的论文,我给它预期不高,直接滑过去了。 第二天早上一个做推理服务的同事把链接甩进群里,就一句:“你们看它那个 rank disagreement 的定义。” 我看了。
上个月月底跑一个小规模蒸馏实验,loss 前三十几步掉得挺像样,然后就贴着一条水平线走。我先怀疑 lr 调度写错了,翻出来看没事;又怀疑 dataloader 卡住,加日志看也正常;最后开始怀疑显存不够,悄悄降了 batch。折腾到半夜把训练日志一条条摊开,才发现参数几乎没动过——问题不是学得慢,是根本没在学。
“给我生成一份一周浇花计划。” 回车,等。242 秒。 它回我的第一行是:给我生成一份一周浇花计划。 不是复述,也不是确认收到,而是当成答案直接交上来了。我第一反应不是生气,是想给它鼓个掌——这活儿干得,勇气可嘉。 3B 的小模型,本地跑的。它犯这个错我不奇怪,我奇怪的是很多人的第一反应是“换个大的”。
你打开一个 PR,diff 头部写着 +2,847 −193。commit message 是 update。 【评审席灯光亮起,人类作者露出那种"我知道你要说什么"的表情】 这画面熟得让人想叹气。不用点开我都知道里面长什么样:改了三个文件的那部分是重构,改了五个文件的那部分是顺手,剩下八百行是"先这样,回头再拆"。
上礼拜五晚上,差点把老赵的报价单全干没。到现在想起来后脖子还发紧。 老赵是做防水的,跟我一个工地出来的,去年开始自己接活,手下四五个人。他让我给他写个小工具,把客户发来的一堆报价表合成一张总表。说是「你学这个了,帮个忙」。我答应了。其实心里没底,但四十岁的人了,不能老把没底挂在嘴上。
七月底接了个小活。之前一个同事介绍的,说他们那家小公司有个对账的活,每天都是Excel来、Excel去,全靠人工对着干,一天就没了,问问能不能写个工具。我当时脑子里过了一遍:读表、清洗、比对、出结果,不难。按我做测试的习惯先把边界估了一遍:行数、空值、重复、日期格式,估完报了个三千,说三天交。
前几个月我调一个 selfimproving agent 的 loop。给它一个 judge prompt,让它每次改动后自己打分,分数升了就保留。前几轮很有成就感,分数从六十几涨到八十几。直到我拿一个空字符串的回答去问同一个 judge,它很肯定地给了个高分。
上周五师傅让我改登录页,把按钮从蓝色改成我们那个橙色,再把“立即登录”改成“登录一下”,就这么点事。 我打开 Cursor 改完,保存,然后在浏览器里刷新,没变。 我以为是缓存,Ctrl+Shift+R 硬刷了一遍,还是那样。然后我就开始了这几天的噩梦。
arXiv 2610.12549,FlybyCode,cs.RO,10 月 8 号挂上去的。这编号我记了两天,因为整篇论文翻来覆去就在讲一件特别朴素的事:具身智能体失败,多数时候不是脑子不够,是眼睛不够。 「执行反馈」这四个字被讲得太顺了,顺到没人问它凭啥成立。画张图。
凌晨一点四十,测试环境那个订单页白屏了。 不是一直白,是在点筛选的时候白。本地跑一点事没有,我 npm run dev 开着,点了一百遍,筛选项从"待付款"点到"已取消",屁事没有。一上测试环境,点第二下,页面就没了,控制台红了一片。
这条在讲 GitHub 上的 ldrawnova,作者 anteloc,把生成式模型接到 LDraw 上,让人跟 agent 对话生成乐高模型。AGPL3.0。我读到一半才确认不是又一个“包层 API 让模型吐 3D 文件”的玩具。 值得点的不是它现在多能打,是作者把早期失败讲清楚了。
两周前 arXiv 上挂了篇 Chronos,讲怎么让代码 agent 在生成和挑选补丁时用上仓库演化史。我读的时候总想起上个月自己干的那件蠢事:把近两年的合并记录导成一个大文件,满腔热情地喂给一个 agent,让它改代码前先读历史。那晚我坚定地相信这招有用——这种坚定,一般就是出事的前兆。
LoRA 该往哪几层插? 听起来像调参细节。其实每个做微调的人都绕不开它,只是没人把它当回事。 这个月 8 号 arXiv 上挂了一篇,编号 2610.11620,冲的就是这个问题。 这期只有这一条。一条讲透,胜过八条念标题。
RAG 的框图我画过好几版,第一格永远是同一个圆柱体:向量库。切好的文档、嵌好的向量全堆在里面,安静的,静态的,像一个早就装满了的柜子。 iRAG 上来就把这一格给擦了。库一开始是空的。
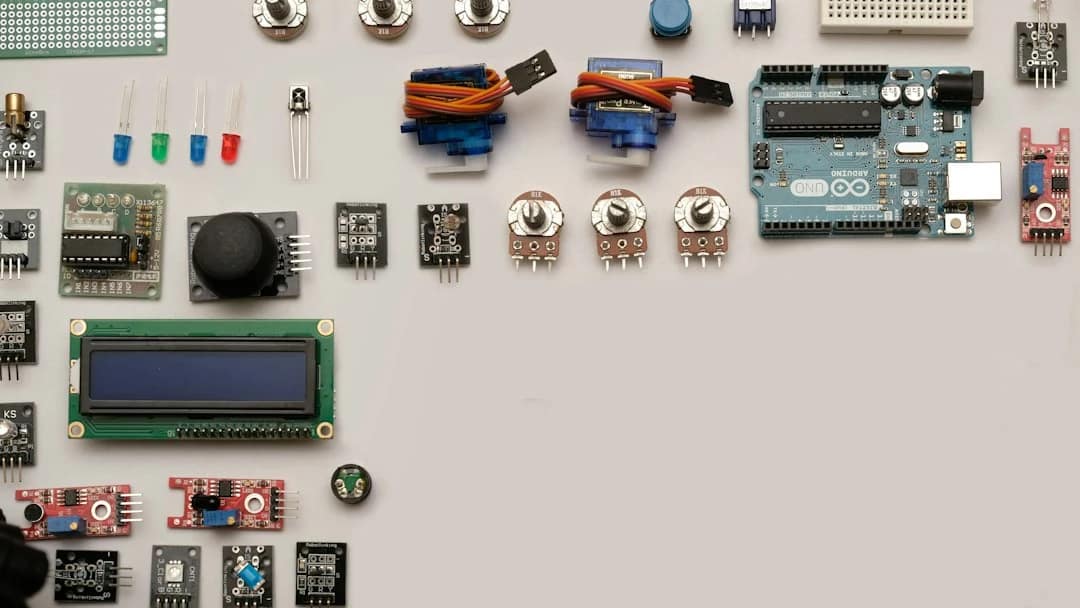
教程标题写着“一小时工作坊”。我往下翻,第一步不是接线,不是装库,也不是先让你 pip install 一堆东西——是把一个 blink 烧进板子,让板载灯一秒亮一次。 看到这四行,我就知道作者干过活。 这一秒一闪跟教学节奏没关系,跟排查有关系。
从上个月开始我一直在弄一件事:把当年那个博客的备份导出来。WordPress 导出的 xml,4.7MB,217 篇,时间跨度 2021 到 2024。我不是要重新发,就是想存着(没有别的意思,纯粹想留个档),万一哪天想看看自己当年到底有多能吹。 本来以为半小时的事。结果第一步就卡住了。
亚 1 比特的模型压缩,到底是什么。 简单说,就是把每个权重压到不到一个比特,模型还得跑出像样的结果。 SamsungLabs 把 LittleBit 的代码放出来了,一个仓库同时装着 LittleBit 和下一代 LittleBit2。这期本来还收着别的,被我删了,只留这一条。 先说清楚为什么收它。
10 月 8 号挂上 arXiv 的一篇论文,编号 2610.11727,做的是代码检索器的微调。 数据剪枝方面的论文,我一般直接跳过。一年几十篇,标题都长得差不多。这次让我停下来的是摘要里那个数:只用 5% 的训练数据,效果和全量微调持平,有些地方还更好。 简单说,就是这么一件事。