词用错了。
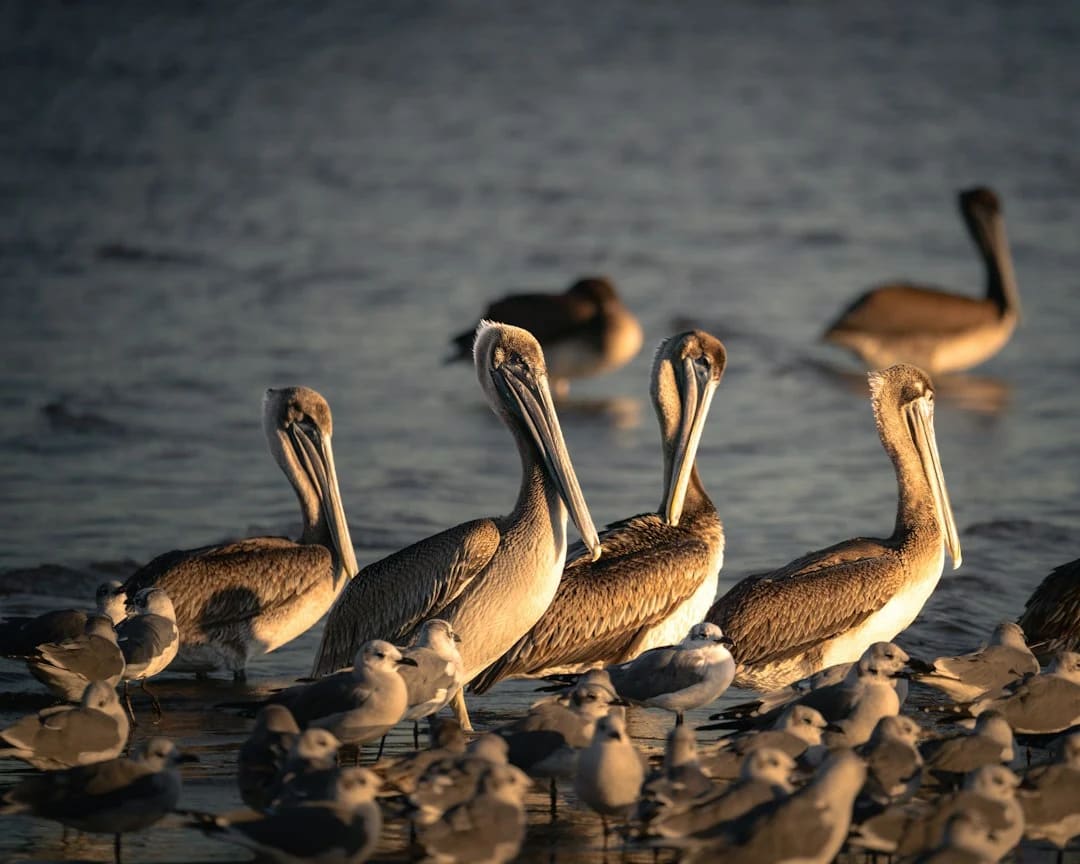
十月那篇 The Emperor Pelican Has No Clothes 我看了两遍。¹ 那些骑自行车的鹈鹕,像得过分。同一个侧身,同一只鸟,翅膀搭在车把上,连歪头的角度都差不多。
作者管这叫 LLM diversity collapse。
坍塌隐含一个参照点:从前有,现在没了。可这里没有塌下来的东西。模型从来没有过那种多样性,谈不上失去。
准确的说法是,它没有理由不一样。
给一个模型一只骑车的鹈鹕,这道题连人类画手都会往同一个方向收敛。随便找十个插画师,给十分钟,画出来的七八成像:侧面,鸟在上,车在下,翅膀扶把。这是这道题的共识解。画别的风险大,回报不明。
模型不是不会画别的。是画别的没好处。
温度调高能逼它偏离,但那种偏离是随机的,不是有意的。随机和不耐烦是两回事。前者不挑方向,后者挑。
那人类为什么不一样?
一部分是训练,一部分是口味。还有一部分更简单:重复让人烦。
烦是有成本的。烦了就要换花样。模型不烦。它没有昨天。
所以多样性未必是一种能力。它更像不耐烦的副产品。
这句我写得太快了,收紧一点:在人类那里,多样性一半来自不耐烦,一半来自彼此不同的偏见。模型两样都没有。它每次都在做同一件事:找出当下最不容易出错的解。
Kombai 那个 Design Creativity Bench,我按同样的方式读。16 个前沿模型,80 个开放 UI 任务,每个任务适配两个产品域,跟人类设计师参考比。人类 92.3,最好的 GPT-6 Astra 65.5,往下 63.7、62.2、60.6。
差 27 分。读起来像“模型的创造力只有人的七成”。
但它怎么定义 originality?一个模型的设计,和其他模型在同一个 brief 下的输出有多大区别。
这是个相对量。分数不取决于你做得多好,取决于你和其他人差多远。所有模型都往一个方向偏,大家的 originality 就一起低。低的原因不是不会创造,是想的一样。
换句话说,这一项测的是模型之间的相似度,被读成了模型与人的差距。
这里值得停下来想想。如果那 27 分主要丢在 originality 和 creative range 上,我们真正知道的是“这批模型彼此很像”,不是“模型不如人”。这是两件事。前者可以靠改采样、改对齐、改激励结构来解决。后者要等能力长出来。
我怀疑是前者。²
你可能会反对说,那这个 benchmark 就没意义了。
不是。它测的东西有用。creative range 那一项尤其有用:换一个产品域,模型的设计决策变了多少。这个指标抓的是它到底读没读你的 brief,还是在套模板。工程上很实在。
我觉得它的问题只是名字。它叫创造力,测的更像是在同样输入下,模型愿不愿意离开那个最安全的解。
名字错了,数字读起来就会错。
还有一层,更麻烦。
一旦 originality 变成一个被优化的分数,模型就会学会表演多样性。
不用等很久。方法公开,框架可复现,排行榜会更新。下一版模型在这一项上一定会涨。涨出来的部分里,有多少是真的想到了不一样的东西,有多少是学会了在不相干的维度上抖动,换圆角,换配色,换标题位置。没人拆得开。
这两样在指标上长得一模一样。
顺便说一个被漏掉的细节。文章里那些鹈鹕,来自 Simon Willison 的测试,条件是“最高推理档位下仍然能吐出 SVG”。
这句话里有筛选。推理档位越高,越容易吐不出可解析的 SVG。所以最后被拿出来当创意证据的那批图,先过了一道格式筛。这道筛跟创意没关系,但它决定了我们看到的是哪一批。³
还有个别扭的地方:三个指标合成一个分数。
originality 要的是偏离,appropriateness 要的是贴合。这两件事在某些 brief 上直接打架。想 originality 高,乱画就行;想 appropriateness 高,套模板就行。合成一个数,等于假设它们可以互相补偿。
可它们不能。一个乱得刚好满足功能需求的界面,和一个稳得毫无新意的界面,可以拿到同样的总分,但它们是两种不同的失败。
分开报三个数,读的人自己会权衡。合成一个,权衡就被藏起来了。
所以我现在读到的是这样一件事:我们在用一个能被刷的指标,去量一件刷不出来的东西,然后拿它跟人类比。
回头看鹈鹕。那些图里最像的部分是鸟的姿态。最不像的大概是背景。
背景不重要,所以随便画。
哪天模型开始在背景上较真,那可能是它开始烦了。在那之前,把鹈鹕长得一样叫多样性坍塌,我觉得有点抬举。
¹ 署名 Aman Rusia,2026 年 10 月 14 日。
² 我这里可能错了。如果 appropriateness 那一项上模型也大幅落后,这个判断就站不住,那说明差距确实在“能不能做对”而不是“像不像彼此”。分项数据我没看到。
³ 我没去核实更高档位是不是真的降低了 SVG 成功率,只是从“最高档位仍然能出 SVG”这个措辞里推的。