
GraphRAG 这词现在被讲得越来越玄,好像一上图就高级了。我先把话说死:图不是重点。
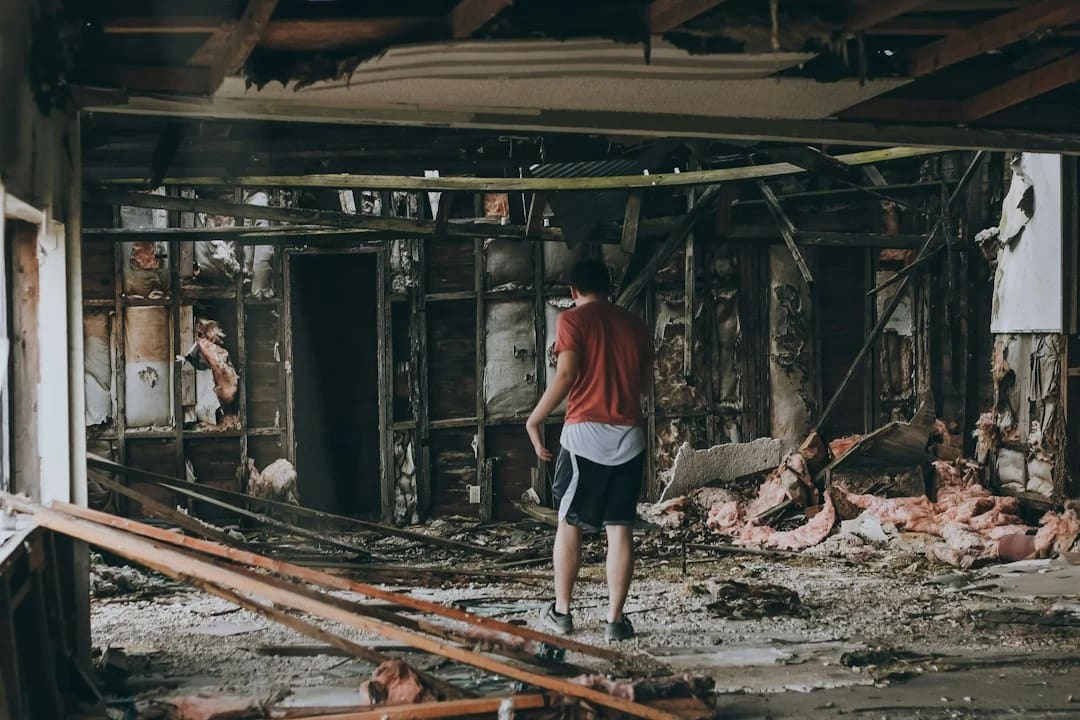
两周前 arXiv 上挂了一篇拿它做风灾后建筑评估的,应用物理分类,龙卷风过后的低层住宅,证据是现场勘察资料加图像。我点进去本来是想看图长什么样的——看完之后,让我坐直的不是图,是它把“没查到”当成一种要显式记下来的状态这件事。
先说说我一开始是怎么画错的。
第一版我画成这样:
   文档A ──引用── 文档B
     │               │
   同主题          同一批次
     │               │
   文档C ──矛盾── 文档D
节点是段落,边是“这俩有关系”,检索的时候从命中的节点出发沿边走两跳,把邻居也一起捞进来。这版我画得挺得意,还跟人讲过:RAG 是查一个点,GraphRAG 是查一个点周围的一圈。听着很顺。
然后我拿它去套这篇论文,套不上。
这篇里的节点压根不是段落,是构件——这面墙、这根梁、这个开间。边也不是“引用”“同主题”这种文档层面的关系,是工程关系:谁撑着谁,谁和谁同属一个受力体系。图不是在把知识库连起来,是在把被评估的那栋楼连起来。
我盯着这两版图对比了半天才反应过来差在哪:第一版是“关于文档的图”,第二版是“关于世界的图”。检索的时候前者帮你扩召回,后者帮你推因果。两件事被同一个词装在一起,难怪我一开始绕进去了。
那“关于世界的图”到底干了普通检索干不了的事?
等等等等,先别急着说“抗幻觉”。这篇要解决的其实不是幻觉,是另一件事:它得在证据缺一半的情况下,回答这栋楼还能不能住、什么时候能修好。
先看普通向量检索给出来的是什么。画张图:
 相似度 0 ────────────────────────────► 1
   ↑              ↑                ↑
 "没查到"      "查到一点"       "查到很像的"
一条数轴,一个分数。问题就出在这条数轴上:0.1 分的那条结果,可能是“这面墙我爬上去看过,没裂”,也可能是“这面墙后面那间屋我压根没进去”。在向量空间里这俩长得一模一样——都不像你的 query。
工程上这俩差得远。一个是阴性证据,一个是空白。你不能因为没查到裂缝就判它安全,也不能因为没进去看就判它危险。
这篇的处理办法是把状态分开记:已确认的损伤、明确的否定证据、还没结论的未解决状态,再加一类旁挂的临时措施(支了根木头顶着,那不算修好,也不算没修)。
我为了好记,硬画了个格子:
   ┌──────────────┬──────────────┐
   │  已确认损伤   │  明确否定证据  │  ← 证据有话说
   ├──────────────┼──────────────┤
   │  未解决状态   │   临时措施     │  ← 证据没话说 / 有动作没结论
   └──────────────┴──────────────┘
这 2x2 是我自己凑的,论文不是这么分的,临时措施严格说也不该跟未解决并排——它是有动作没结论,跟“没结论也没动作”不是一回事。我这么摆纯粹因为它好记。别拿我这格子当论文的图看,这是我给自己搭的脚手架。
真正关键的不是分几类,是分完之后配了个弃权:判断不了就说判断不了,不许硬凑一个“大概安全”。这一格我觉得比图本身还重要。
然后才是图干活的地方。检索在这里不是“找最像的文本”,是两件事并行:一是找可比的建筑情景(同类型、同构造、被同类风压抽过的),二是顺着工程关系在图上走路径,从“这面墙坏了”推到“上面那层不能住”。后者是路径,不是相似度——相似度永远给不了“因为 A 撑着 B”。
我在这儿咔哒一下扣上的其实是另一件事,跟检索无关,是它后面那步工期。
修一栋受灾的楼不是一串联的独立任务。搭脚手架要等结构评估出结论,评估结论要等那面墙的阴性证据到位,屋顶翻修又要等脚手架。你把这几个工序的工期各自算个均值加一加,出来的是错的——它们在一条链上,一个卡住整条链往后滑。这篇用蒙特卡洛在行动依赖网络里滚这个不确定性,滚出来的分布尾巴拉得很长。
✨ 这玩意儿真的太酷了:不确定性不是在每个工序里独立掷骰子,是顺着依赖边往下传的。同一条链上滚一遍和分开算一遍,报给业主的“最晚什么时候能回去住”能差出好几周!
那图是不是就万能了?不是。打个比方,图就像一张关系地图——但这个比喻在这儿漏风。
地图上没画的地方,你会默认那儿什么都没有;实际上更可能是“没勘测”。图给你的是已知关系的全貌,不是世界的全貌。而这篇后面那一堆弃权、证据优先级、矛盾处理的机制,本质上都是在给图打补丁——因为图本身不知道自己哪儿缺一块。图厉害,但图的边界得靠图外面的东西兜着。
这也就接上了它的消融。工程上下文、证据保护、图路径遍历,三样都有贡献,论文那句话里没排座次。我的猜测是前两样吃掉了一大半——你肯把领域约束、把“阴性证据也得留档”这种规矩写进流程,本身就能拉开差距;图路径遍历是上面那层。所以以后看到有人把这类工作的功劳一股脑塞给“上了图”,我一般是存疑的。
跟 Baseline RAG 和 Structured Baseline RAG 比,它在关键建筑状态和恢复结果上一致性更好,还留着可追溯的推理链和证据来源——这一条在工程场景里其实比准确率更要命,因为最后得有人签字。
扯远了,拉回来。
这篇给我的东西不是“GraphRAG 更强”,是它把 RAG 里一直被糊过去的一段显式化了:检索不是一个打分,检索是“我到底知道什么、不知道什么、哪些是我明确否掉的”。图在这个框架里排第二,排第一的是那套状态划分和弃权。
自检一下:现在你能不能用自己的话讲清楚——为什么“没查到裂缝”和“没进去看”在向量库里是同一件事,到了工程判断里却完全不是一回事?卡住的地方告诉我,多半是我图没画清楚,那我重画。
下期想画开哪个,你说了算。我手上压着两个候选:一个是“为什么向量检索在多跳问题上一定会断”,一个是“不确定性传播到底能不能不靠蒙特卡洛”。哪个更想看?
本期画开:图不是让你查得更多,是让你说得清“哪儿没查到”。